Харнесс-инженерия для пользователей кодовых агентов
Чтобы кодовые агенты могли работать с меньшим надзором, нам нужны способы повышать уверенность в их результатах. У нас, инженеров, есть естественный барьер доверия к коду, написанному ИИ: LLM недетерминированы, не знают нашего контекста и не «понимают» код по-настоящему — они оперируют токенами. В этой статье разбирается ментальная модель, объединяющая зарождающиеся концепции инженерии контекста и харнесс-инженерии, чтобы такое доверие выстроить.
2 апреля 2026
Перевод статьи Birgitta Böckeler на martinfowler.com. Оригинал: Harness engineering for coding agent users.
Биргитта — выдающийся инженер (Distinguished Engineer) и эксперт по AI-ассистированной разработке в Thoughtworks. Более 20 лет опыта в ролях разработчика, архитектора и технического лидера.
Термин харнесс (harness, «обвязка») стал сокращением для «всё в ИИ-агенте, кроме самой модели»: агент = модель + харнесс. Определение очень широкое, и его стоит сузить применительно к распространённым категориям агентов. Позволю себе определить значение термина в ограниченном контексте использования кодового агента. В кодовых агентах часть харнесса уже встроена: системный промпт, выбранный механизм извлечения кода или даже сложная система оркестрации. Но кодовые агенты также дают нам, пользователям, множество возможностей построить внешний харнесс под наш сценарий и нашу систему.
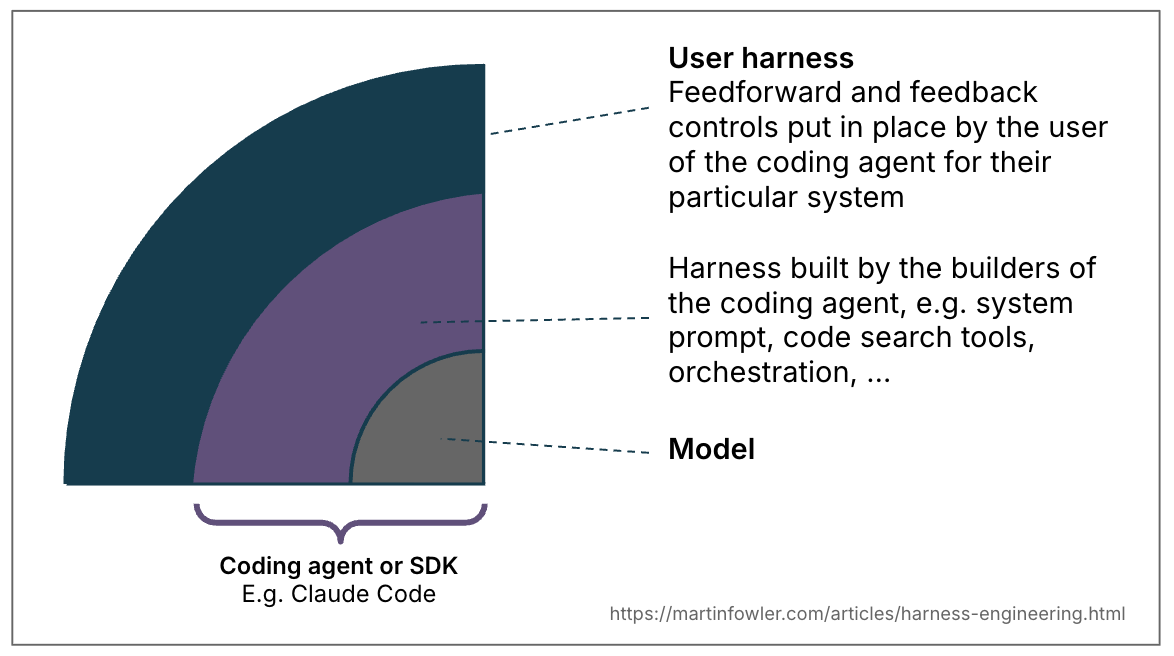
Рисунок 1: термин «харнесс» означает разное в зависимости от ограниченного контекста.
Хорошо построенный внешний харнесс решает две задачи: повышает вероятность того, что агент сделает всё правильно с первого раза, и создаёт петлю обратной связи, которая самокорректирует как можно больше проблем ещё до того, как их увидит человек. В итоге должно стать меньше рутины на ревью и выше качество системы, а вдобавок — меньше впустую потраченных токенов.
Прямая и обратная связь
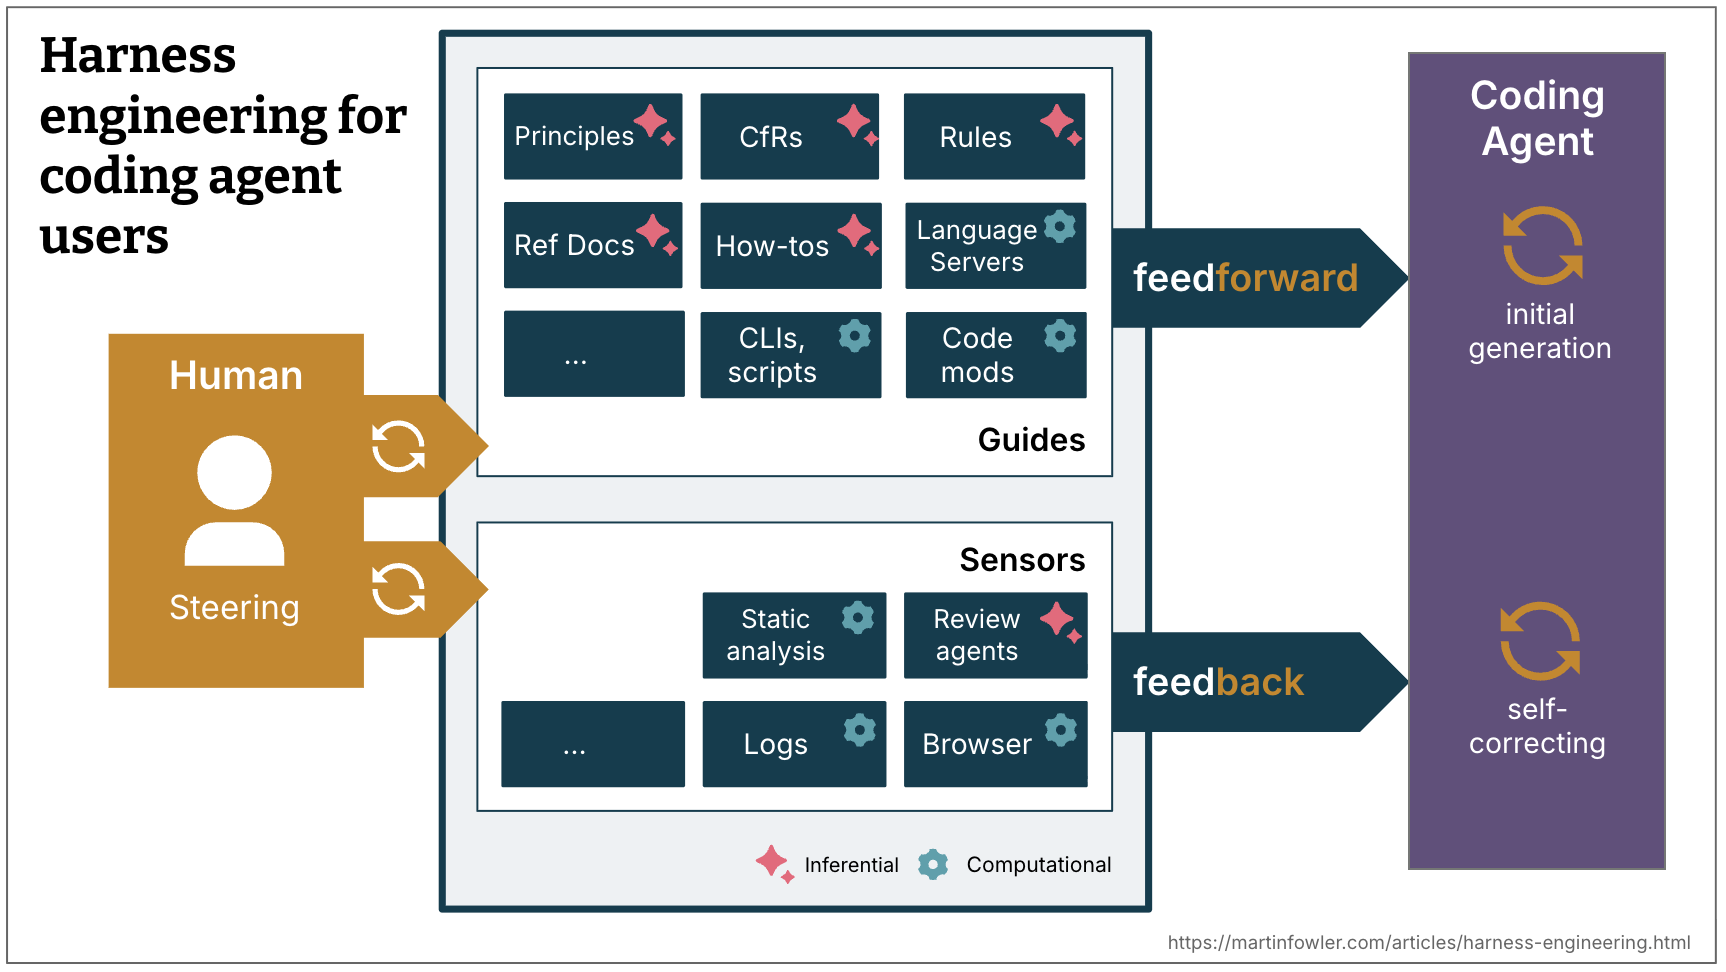
Обвязывая кодовый агент, мы одновременно предвосхищаем нежелательные результаты и стараемся их предотвратить, и расставляем сенсоры, позволяющие агенту самокорректироваться:
- Направляющие (guides, управление по прямой связи, feedforward) — предвосхищают поведение агента и стремятся направить его до того, как он начнёт действовать. Направляющие повышают вероятность хорошего результата с первой попытки.
- Сенсоры (управление по обратной связи, feedback) — наблюдают после действий агента и помогают ему скорректироваться. Особенно эффективны, когда выдают сигналы, оптимизированные для восприятия LLM: например, сообщения линтера, содержащие инструкции для самокоррекции, — своего рода позитивная инъекция промпта.
По отдельности получится либо агент, который раз за разом повторяет одни и те же ошибки (только обратная связь), либо агент, который заучивает правила, но никогда не узнаёт, сработали ли они (только прямая связь).
Вычислительное и инференциальное
У направляющих и сенсоров есть два типа исполнения:
- Вычислительное (computational) — детерминированное и быстрое, выполняется на CPU. Тесты, линтеры, проверки типов, структурный анализ. Работают за миллисекунды или секунды; результатам можно доверять.
- Инференциальное (inferential) — семантический анализ, ревью кода с помощью ИИ, «LLM как судья». Обычно выполняется на GPU или NPU. Медленнее и дороже; результаты менее детерминированы.
Вычислительные направляющие повышают вероятность хорошего результата за счёт детерминированного инструментария. Вычислительные сенсоры настолько дёшевы и быстры, что могут запускаться при каждом изменении параллельно с работой агента. Инференциальные элементы управления, конечно, дороже и недетерминированнее, зато позволяют давать богатые инструкции и добавлять семантическую оценку. Несмотря на недетерминизм, инференциальные сенсоры особенно повышают доверие при использовании сильной модели — точнее, модели, подходящей под конкретную задачу.
Примеры
| Направление | Вычислительное / инференциальное | Примеры реализации | |
|---|---|---|---|
| Соглашения по коду | прямая связь | Инференциальное | AGENTS.md, скиллы |
| Инструкции по начальной сборке нового проекта | прямая связь | Оба | Скилл с инструкциями и скриптом инициализации |
| Код-моды | прямая связь | Вычислительное | Инструмент с доступом к рецептам OpenRewrite |
| Структурные тесты | обратная связь | Вычислительное | Pre-commit-хук (или хук кодового агента), запускающий тесты ArchUnit на нарушение границ модулей |
| Инструкции по проведению ревью | обратная связь | Инференциальное | Скиллы |
Контур управления
Работа человека здесь — управлять агентом, итерируя по харнессу. Всякий раз, когда проблема повторяется несколько раз, элементы прямой и обратной связи стоит улучшить, чтобы она стала менее вероятной или вовсе исчезла.
В контуре управления можно, разумеется, использовать ИИ и для улучшения самого харнесса. С кодовыми агентами стало гораздо дешевле строить собственные элементы контроля и собственный статический анализ. Агенты могут помочь писать структурные тесты, генерировать черновики правил из наблюдаемых паттернов, скелетировать кастомные линтеры или создавать how-to-руководства по результатам «археологии» кодовой базы.
Тайминг: держать качество левее
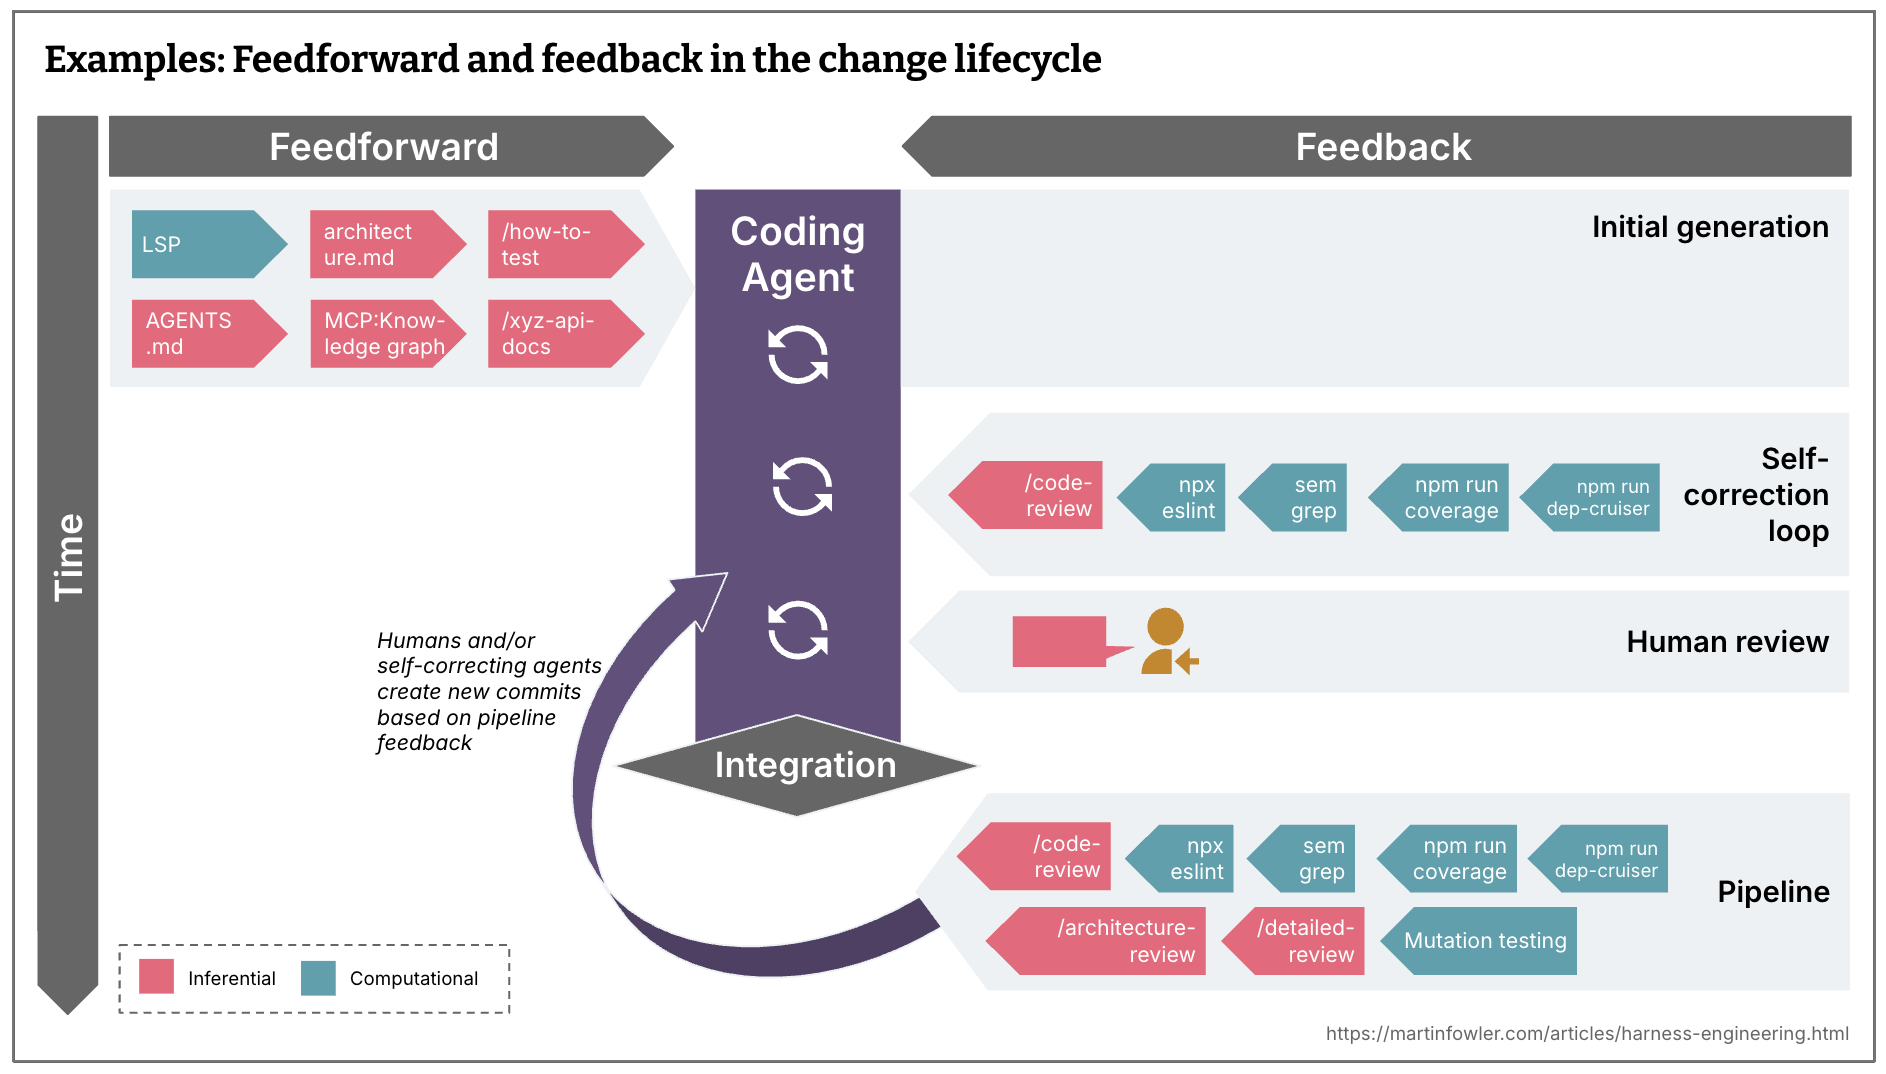
Команды, практикующие непрерывную интеграцию, всегда решали задачу распределения тестов, проверок и ревью по временной шкале разработки в зависимости от их стоимости, скорости и критичности. Если стремиться к непрерывной доставке, в идеале каждый коммит должен быть деплойабельным. Проверки хочется расположить как можно левее на пути в прод: чем раньше находится проблема, тем дешевле её исправить. Сенсоры обратной связи, включая новые инференциальные, нужно распределять по жизненному циклу соответственно.
Прямая и обратная связь в жизненном цикле изменения
- Что достаточно быстро, чтобы запускать до интеграции — или даже до создания коммита? (линтеры, быстрые наборы тестов, базовый агент ревью кода)
- Что дороже и потому должно выполняться только после интеграции, в пайплайне, в дополнение к повторному прогону быстрых проверок? (мутационное тестирование, более широкое ревью кода, учитывающее общую картину)
Непрерывные сенсоры дрейфа и здоровья
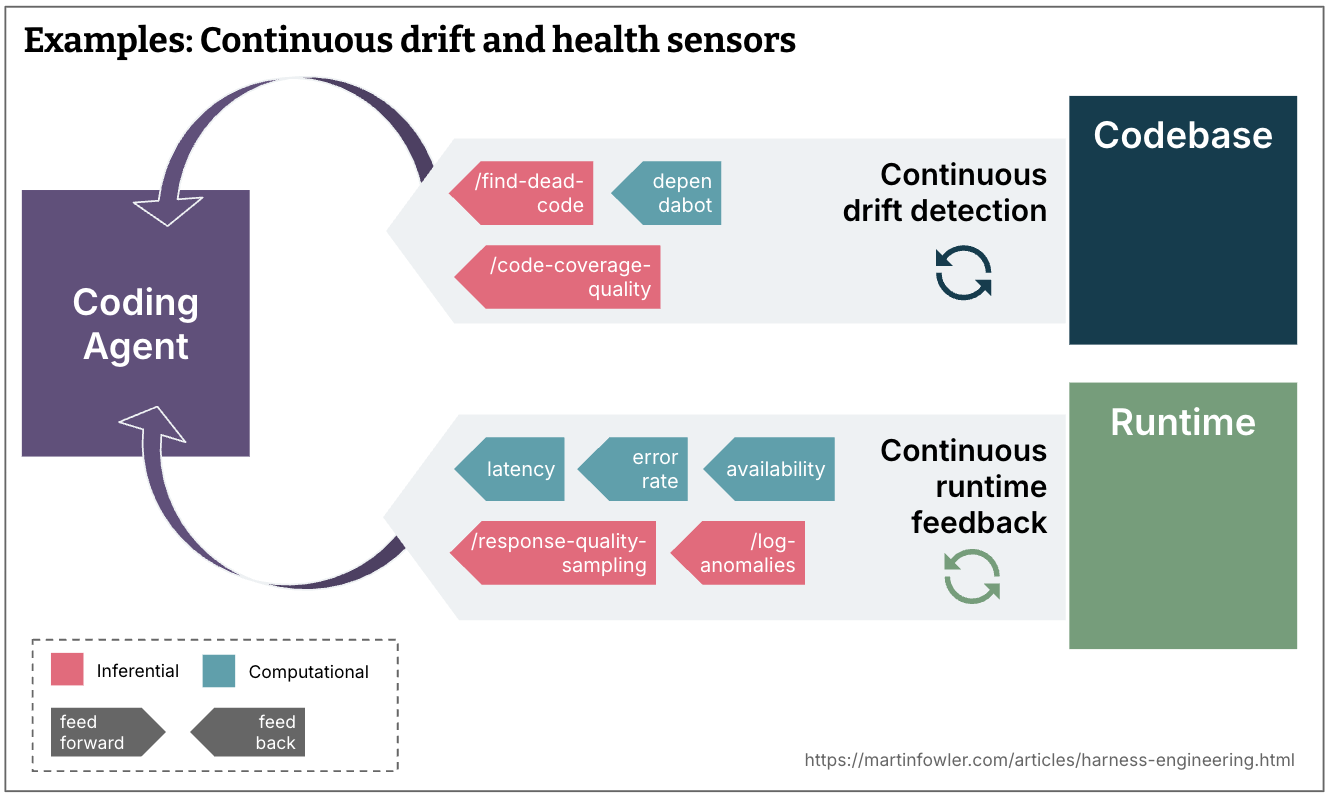
- Какой дрейф накапливается постепенно и должен отслеживаться сенсорами, работающими непрерывно по кодовой базе, вне жизненного цикла изменений? (поиск мёртвого кода, анализ качества тестового покрытия, сканеры зависимостей)
- Какую обратную связь из рантайма могли бы мониторить агенты? (например, отслеживать деградацию SLO и предлагать улучшения или ИИ-судьи, непрерывно сэмплирующие качество ответов и помечающие аномалии в логах)
Категории регулирования
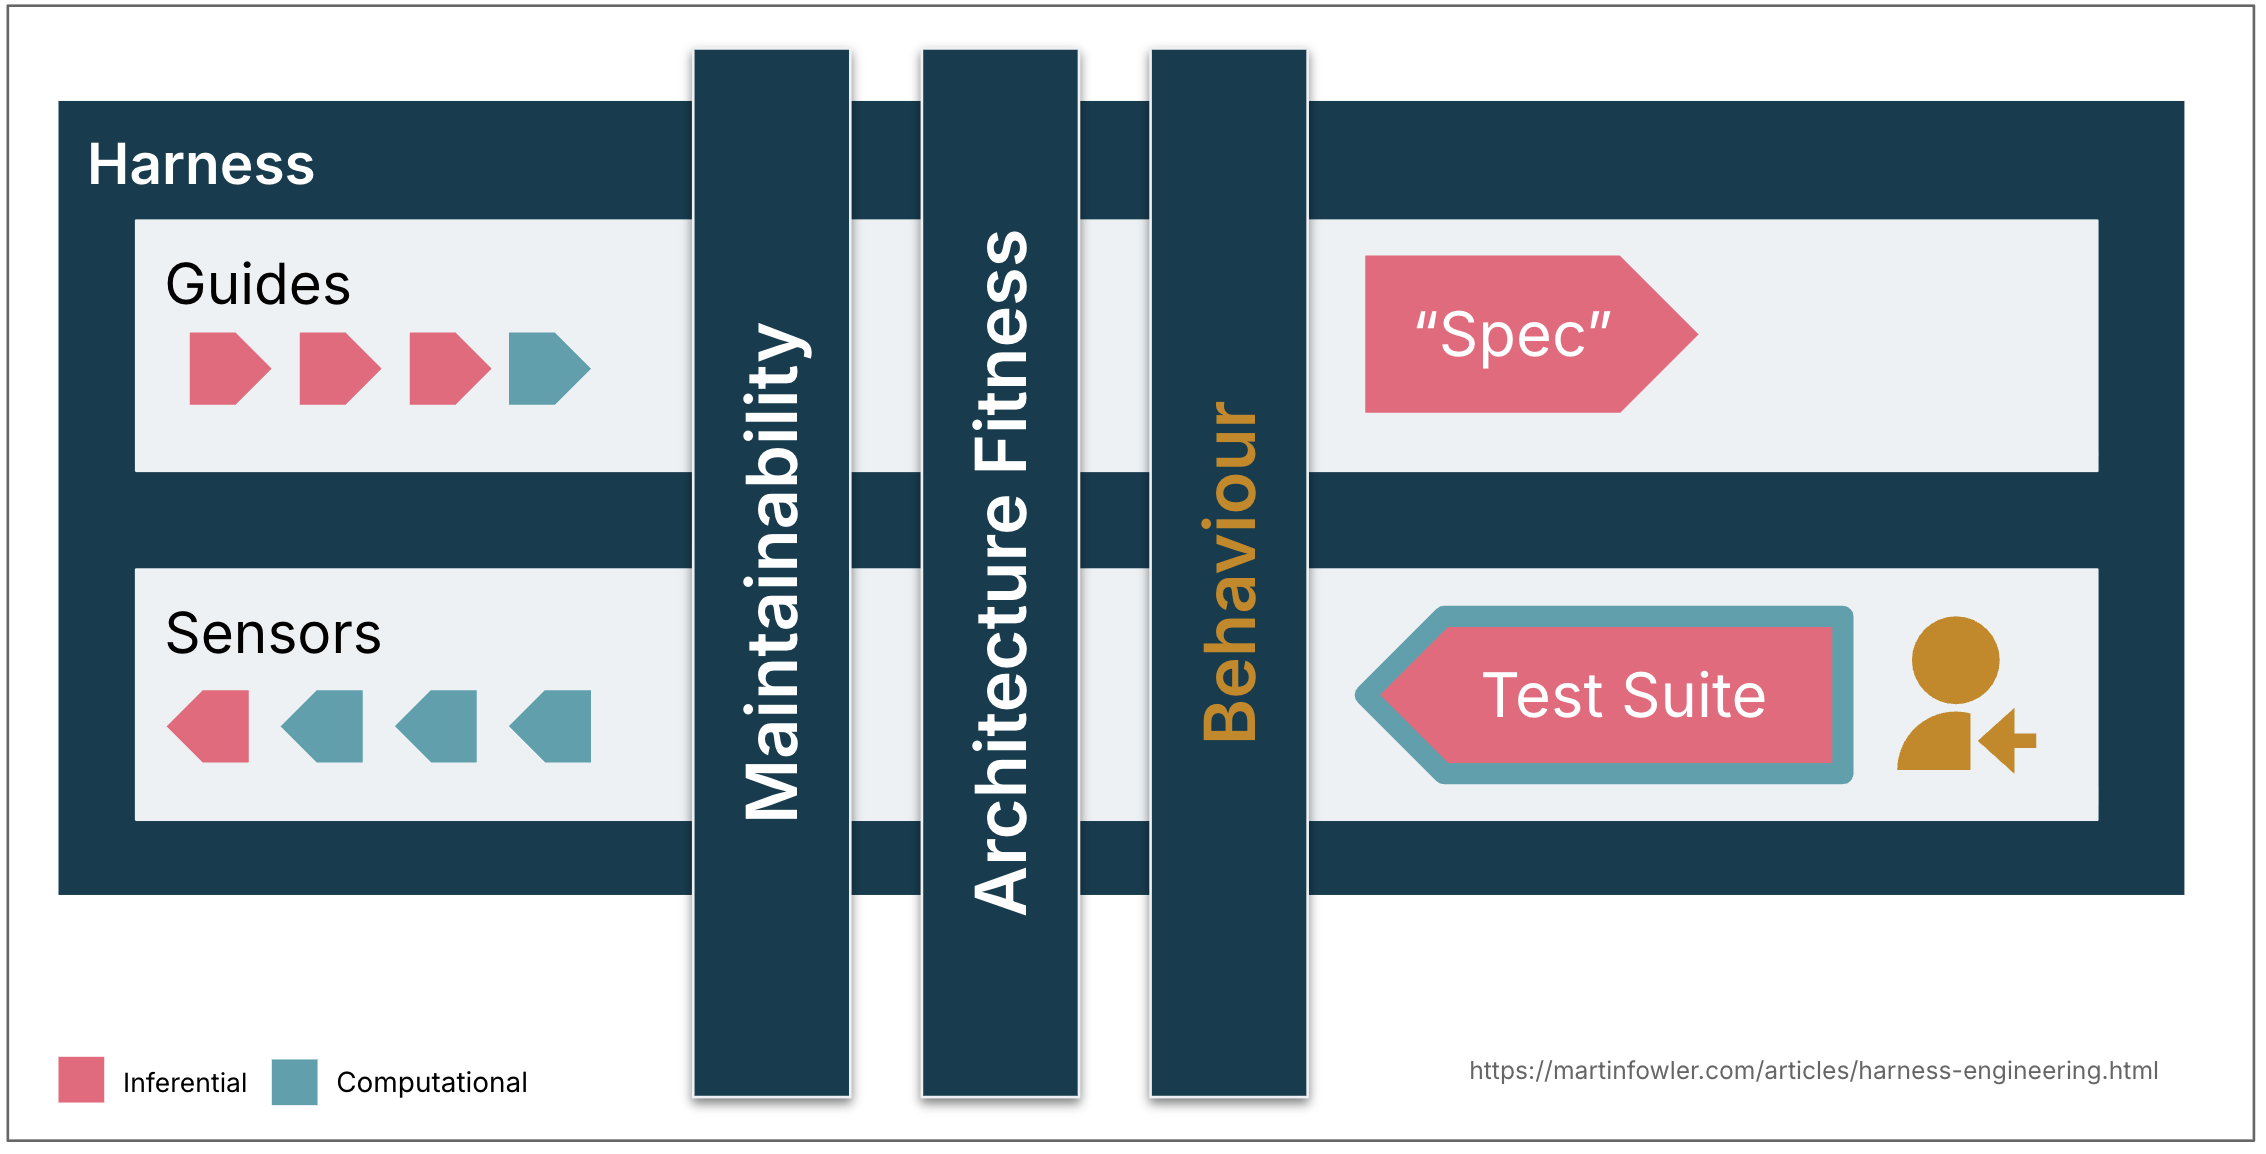
Харнесс агента работает как кибернетический регулятор, сочетая прямую и обратную связь, чтобы вести кодовую базу к желаемому состоянию. Полезно различать несколько измерений этого состояния — по тому, что именно харнесс должен регулировать. Такое различение помогает, потому что податливость харнессу и сложность различаются между категориями, а уточнение слова даёт более точный язык для термина, который иначе слишком общий.
На сегодня мне кажутся полезными три категории:
Харнесс поддерживаемости
Почти все примеры в этой статье относятся к регулированию внутреннего качества кода и поддерживаемости. Пока это самый простой тип харнесса: у нас уже есть масса готового инструментария.
Чтобы оценить, насколько эти идеи харнесса поддерживаемости повышают моё доверие к агентам, я сопоставила их с каталогом типовых ошибок кодовых агентов, который составила раньше.
Вычислительные сенсоры надёжно ловят структурные проблемы: дублирование кода, цикломатическую сложность, пробелы в покрытии тестами, архитектурный дрейф, нарушения стиля. Они дешёвые, проверенные и детерминированные.
LLM могут частично закрывать проблемы, требующие семантической оценки — семантически дублирующийся код, избыточные тесты, лобовые фиксы, переусложнённые решения — но дорого и вероятностно. Не на каждом коммите.
А ряд высокоимпактных проблем не ловит надёжно никто: неверная диагностика проблемы, переинжиниринг и лишняя функциональность, неправильно понятые инструкции. Иногда их удаётся поймать, но недостаточно надёжно, чтобы снизить надзор. Корректность вообще вне зоны ответственности любого сенсора, если человек изначально не сформулировал чётко, что ему нужно.
Харнесс архитектурной пригодности
Сюда входят направляющие и сенсоры, определяющие и проверяющие архитектурные характеристики приложения. По сути — фитнес-функции.
Примеры:
- Скиллы, заранее передающие агенту требования к производительности, и тесты производительности, которые сообщают агенту по обратной связи, улучшил он их или ухудшил.
- Скиллы, описывающие соглашения по коду ради наблюдаемости (стандарты логирования), и инструкции по отладке, которые просят агента оценить качество имевшихся в его распоряжении логов.
Харнесс поведения
Это слон в комнате: как направлять и измерять, ведёт ли приложение себя функционально так, как нам нужно? На данный момент большинство людей, дающих кодовым агентам высокую автономию, делают так:
- Прямая связь: функциональная спецификация (разной степени детализации — от короткого промпта до описаний на несколько файлов).
- Обратная связь: проверка, что сгенерированный ИИ набор тестов зелёный и имеет приемлемое покрытие; некоторые даже следят за его качеством мутационным тестированием. Плюс ручное тестирование.
Такой подход слишком сильно полагается на сгенерированные ИИ тесты — этого пока недостаточно. Некоторые мои коллеги видят хорошие результаты с паттерном approved fixtures, но в одних областях он применяется легче, чем в других. Они используют его точечно, где он подходит: это не универсальный ответ на проблему качества тестов.
В целом нам ещё многое предстоит понять про хорошие харнессы функционального поведения, которые повысили бы уверенность настолько, чтобы снизить надзор и ручное тестирование.
Насколько кодовая база поддаётся харнессу
Не всякая кодовая база одинаково поддаётся обвязке. У кодовой базы на строго типизированном языке проверка типов уже сама по себе является сенсором; чётко определяемые границы модулей позволяют задать архитектурные ограничения; фреймворки вроде Spring прячут детали, о которых агенту вообще не нужно думать, и тем самым неявно повышают его шансы на успех. Без этих свойств соответствующие элементы контроля просто нечем построить.
По-разному это проявляется для greenfield и legacy. Greenfield-команды могут заложить податливость с первого дня: технологические и архитектурные решения определяют, насколько управляемой будет кодовая база. У legacy-команд, особенно с приложениями, накопившими много технического долга, задача сложнее: харнесс нужнее всего там, где его труднее всего построить.
Шаблоны харнесса
В большинстве предприятий есть несколько общих топологий сервисов, покрывающих 80% потребностей: бизнес-сервисы, отдающие данные через API; сервисы обработки событий; дашборды данных. Во многих зрелых инженерных организациях эти топологии уже оформлены в шаблоны сервисов. В будущем они могут эволюционировать в шаблоны харнесса: набор направляющих и сенсоров, привязывающих кодового агента к структуре, соглашениям и технологическому стеку конкретной топологии. Команды могут начать выбирать стек и структуру отчасти исходя из того, какие харнессы для них уже существуют.
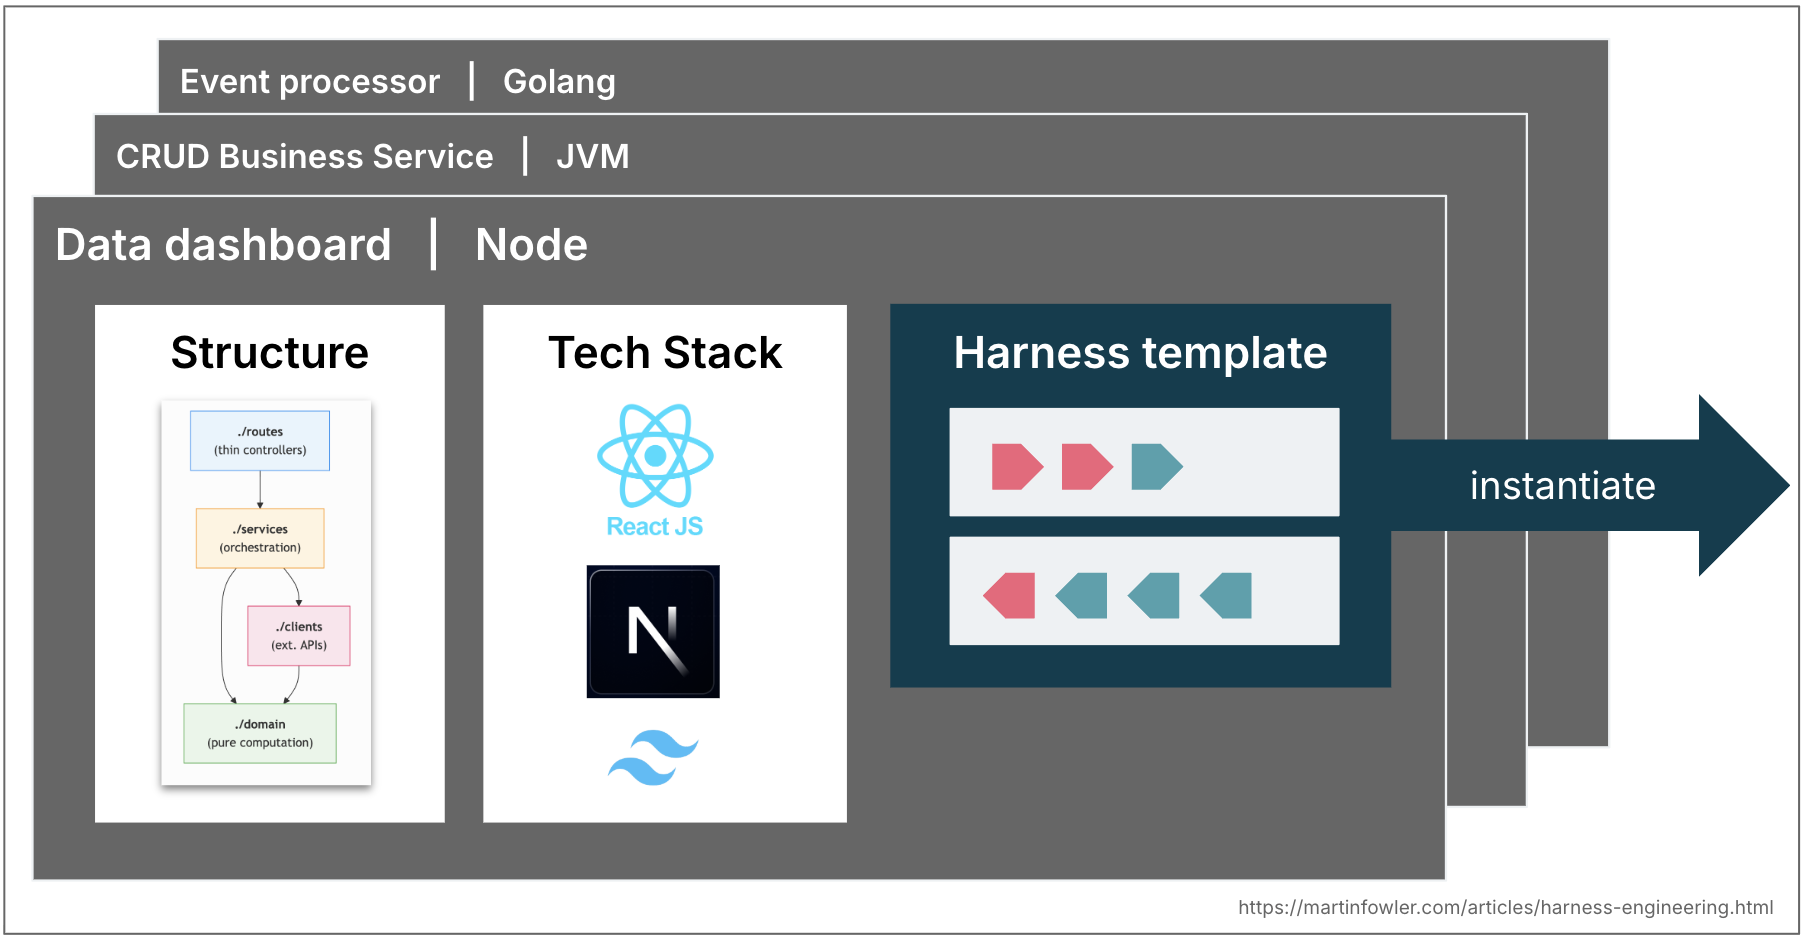
Разумеется, мы столкнёмся с теми же сложностями, что и с шаблонами сервисов. Как только команды инстанцируют их, те начинают рассинхронизироваться с улучшениями в апстриме. Шаблоны харнесса будут иметь те же проблемы с версионированием и контрибуциями — возможно, даже острее из-за недетерминированных направляющих и сенсоров, которые сложнее тестировать.
Роль человека
Мы, разработчики-люди, приносим в каждую кодовую базу свои навыки и опыт как неявный харнесс. Мы впитали соглашения и хорошие практики, мы чувствовали когнитивную боль от сложности и знаем, что на коммите стоит наше имя. Мы также несём в себе организационный контекст: понимание того, чего пытается достичь команда, какой технический долг терпится по бизнес-причинам и как выглядит «хорошо» именно в этом контексте. Мы идём маленькими шагами в человеческом темпе, и это создаёт пространство для размышлений, в котором опыт успевает сработать.
У кодового агента ничего этого нет: ни социальной ответственности, ни эстетического отвращения к функции в 300 строк, ни интуиции «у нас так не делают», ни организационной памяти. Он не знает, какое соглашение несущее, а какое — просто привычка, и вписывается ли технически правильное решение в то, чего пытается добиться команда.
Харнессы — попытка экстернализовать и сделать явным то, что даёт опыт разработчика-человека, но предел у неё есть. Построение согласованной системы направляющих, сенсоров и петель самокоррекции стоит дорого, поэтому приоритеты нужно расставлять с ясной целью: хороший харнесс не обязательно должен стремиться полностью устранить человека — он должен направлять наш вклад туда, где он важнее всего.
Отправная точка и открытые вопросы
Изложенная здесь ментальная модель описывает техники, которые уже применяются на практике, и помогает структурировать обсуждение того, что ещё предстоит выяснить. Её цель — поднять разговор выше уровня отдельных функций: от скиллов и MCP-серверов к тому, как мы стратегически проектируем систему контроля, дающую настоящую уверенность в том, что производят агенты.
Вот несколько примеров, связанных с харнессами, из текущей дискуссии:
- Команда OpenAI задокументировала устройство своего харнесса: слоистая архитектура, enforced кастомными линтерами и структурными тестами, и регулярная «сборка мусора», которая сканирует дрейф и поручает агентам предлагать исправления. Их вывод: «Сейчас наши самые сложные задачи сосредоточены на проектировании сред, петель обратной связи и систем контроля».
- Рассказ Stripe о своих minion'ах описывает, среди прочего, pre-push-хуки, которые по эвристике запускают релевантные линтеры; они подчёркивают, насколько важен для них «сдвиг обратной связи влево», а их «blueprints» показывают, как они встраивают сенсоры обратной связи в рабочие процессы агентов.
- Мутационное и структурное тестирование — примеры вычислительных сенсоров обратной связи, которые раньше недоиспользовались, а теперь переживают ренессанс.
- Среди разработчиков всё чаще обсуждают интеграцию LSP и code intelligence в кодовые агенты — примеры вычислительных направляющих прямой связи.
- Я слышу истории от команд Thoughtworks о борьбе с архитектурным дрейфом сразу вычислительными и инференциальными сенсорами: например, повышение качества API смесью агентов и кастомных линтеров или повышение качества кода «армией уборщиков».
Понять ещё предстоит немало — и не только про уже упомянутый харнесс поведения. Как сохранять согласованность харнесса по мере роста, чтобы направляющие и сенсоры не противоречили друг другу? Насколько можно доверять агентам разумные компромиссы, когда инструкции и сигналы обратной связи указывают в разные стороны? Если сенсоры никогда не срабатывают — это признак высокого качества или недостаточных механизмов обнаружения? Нужен способ оценивать покрытие и качество харнесса — аналогично тому, что покрытие кода и мутационное тестирование делают для тестов. Сейчас элементы прямой и обратной связи разбросаны по этапам доставки, и есть реальный потенциал для инструментов, которые помогут конфигурировать их, синхронизировать и рассуждать о них как о системе. Построение внешнего харнесса складывается в непрерывную инженерную практику, а не разовую настройку.
Благодарности
Большое спасибо команде Doppler за увлекательную дискуссию на нашей последней встрече по технологическому радару и в особенности Кифу Моррису, поднявшему тему кибернетики. Спасибо Неду Летчеру, Крису Форду и Бену О'Махони за разговоры о том, чем харнесс вообще является, и Маттео Ваккари — за идеи о харнессе поведения. И всем, кто нашёл время прочитать черновик и дать массу ценных замечаний: Christoph Burgmer, Jörn Dinkla, Michael Feathers, Karrtik Iyer, Swapnil Phulse, Paul Sobocinski, Zhenjia Zhou.
GenAI (Claude и Claude Code) использовался для исследования, извлечения релевантных идей из существующих заметок и шлифовки формулировок.
Ещё про сенсоры
Я написала статью-продолжение, описывающую мои эксперименты и выводы про сенсоры для поддерживаемости.
Ранняя заметка
В начале февраля я опубликовала заметку с первыми мыслями о харнесс-инженерии, когда термин только появился. Тот пост привлёк много внимания. Эта статья заменяет заметку, поэтому исходный URL заметки мы перенаправили сюда: считаем эту страницу более полезным ресурсом для читателей.
Значимые правки
2 апреля 2026: опубликована полная статья, включая введение направляющих, сенсоров, вычислительных и инференциальных элементов и шаблонов харнесса.
17 февраля 2026: опубликована начальная заметка о харнесс-инженерии.